【Agent】Agent 后端架构设计
本文整理自一个讲 Agent 后端设计的视频(见文末参考资料),结合视频画面重新梳理了它的完整思路:从一个 Agent 后端的工作流程出发,推导出领域层、应用层、适配层三层架构,定义 Session、Tool、Context 等核心抽象,最后用组装根把所有具体实现接起来。这套设计思路不只适用于 Agent,也可以迁移到任何后端系统。
从一个循环开始
Agent 的本质就是一个循环:把上下文发给模型,收到回复,执行工具,把结果塞回上下文,再发给模型,如此往复。一个最小实现可能只有一个 while True 循环。但要把这个循环做成一个真正可用的后端系统,问题马上就出现了:
- 如何适配多种模型协议,OpenAI、Anthropic、Google 的请求格式各不相同;
- 如何确保模型发出的命令执行是安全的,错误地删除文件或执行危险操作的调用需要被拦下来;
- 模型能力在快速进化,如何设计 harness 让系统保持可扩展。
这些问题决定了:直接把循环写成一个函数是不够的,需要先梳理清楚整个系统的工作流程,再做架构设计。
Agent 后端的工作流程
把一个 Agent 后端从头到尾跑一遍,流程是这样的:
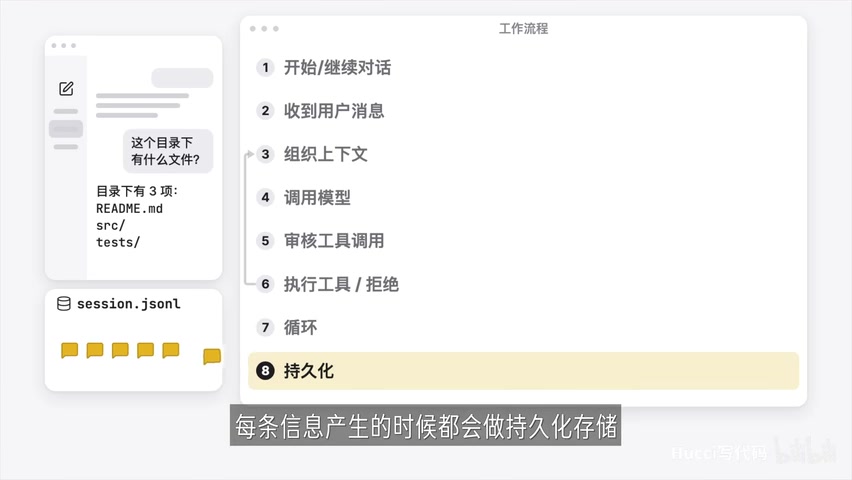
- 开始一个新对话,或者继续之前的旧对话;
- 收到前端发送的用户消息;
- 将指令、可用工具、历史消息组织成上下文,发送给模型;
- 收到模型回复,如果回复中包含工具调用,另外调一次模型审核这次调用是否合理;
- 审核通过则执行工具,把执行结果连同之前的上下文一起重新发给模型;审核不通过则把拒绝原因返回给模型;
- 重复上述步骤,直到模型的回复不再包含工具调用,或者循环次数达到上限;
- 结束本轮对话,把结果反馈给前端;
- 整个过程中,每条消息产生时都会做持久化存储。
这个流程本身并不复杂,复杂的是怎么把它组织成可维护、可测试的代码。
为什么不能一个函数写到底
不带任何设计去实现上面的流程,最终大概就是一个函数里塞满所有步骤。这样做有两个直接的坏处:
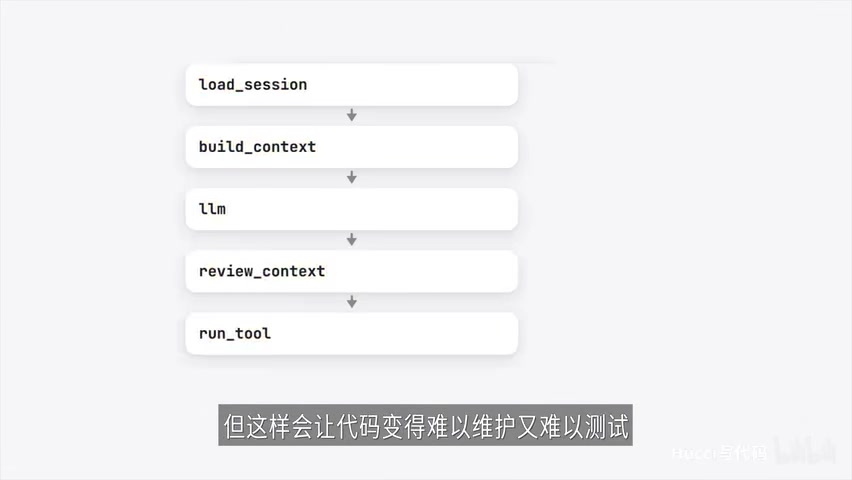
- 难以维护:想把模型从 OpenAI 协议换成 Anthropic 协议,需要同时修改多个地方,改动散落在函数的各个角落;
- 难以测试:想测试流程逻辑,就必须真实调用模型,既花钱又很慢,测试根本跑不起来。
解决方法是分层。把不同性质的工作拆到不同的层里,每层只负责一类事情。这个视频给出的划分是三层:领域层、应用层、适配层。
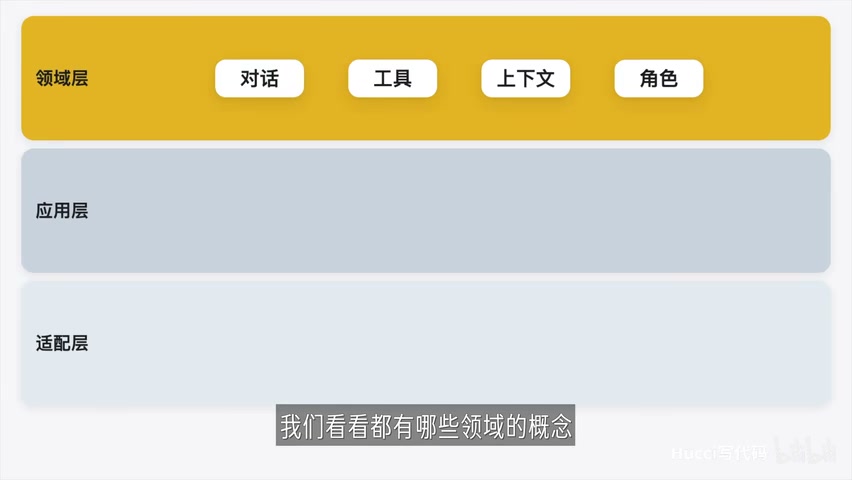
- 领域层定义系统自己的语言:什么是对话、什么是工具、什么是上下文。每个系统对这些概念都有自己的理解,怎么定义它们决定了这个系统会是什么样子;
- 应用层把这些概念编排成完整的应用:调度领域层的各种概念,安排先做什么后做什么,什么时候继续循环,什么时候结束;
- 适配层把系统外部的东西翻译成系统自己的语言:存储对话时把 Session 对象翻译成 JSONL 或数据库记录,调用模型时把系统概念翻译成各家 API 的参数,再把模型回复翻译回系统概念。
适配层和应用层都是为领域层而生的。如何定义领域,就是一个系统的本质。
领域层:定义系统的核心概念
领域概念总共有四个:对话、工具、上下文、角色。逐一来看。
对话:Session
对话是整个系统最重要的概念,因为整个系统的表现形式就是对话。领域层用一个 Session 对象定义对话:
- id 字段:这次对话的标识,字符串类型,用于之后复用这个对话;
- messages 字段:消息列表,随对话增长,所以 Session 还提供一个 append 方法来加入新消息。
messages 列表里有三种消息类型:
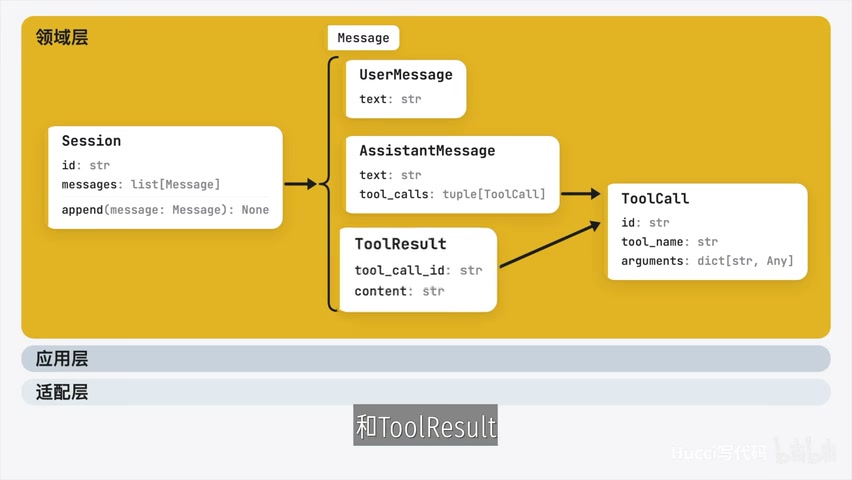
- UserMessage:用户发的消息,装文本;
- AssistantMessage:模型的回复,除了文本还可能携带工具调用,每个工具调用用一个 ToolCall 对象包装,包含调用 ID、工具名称和参数;
- ToolResult:工具调用的结果,通过 ToolCall 的 ID 关联到具体的调用,content 字段存放执行结果。
工具:Tool
组织上下文时需要告诉模型有哪些工具可用,流程中还需要真正执行工具。领域层用 Tool 对象定义工具:
- name 字段:工具名称,模型通过它指定要调用的工具;
- description 字段:工具用途描述,模型据此决定什么时候用这个工具;
- parameters 字段:参数说明,模型据此知道要传入什么参数;
- execute 方法:工具最重要的意义是可被执行,输入是模型返回的参数,输出是 ToolResult 里的 content。
上下文:Context
调用模型时发送的上下文也需要被明确定义。领域层用 Context 对象定义上下文:
- instruction 字段:指令,告诉模型这次要做什么、遵守什么规则;
- tools 字段:本次可用的工具列表;
- history 字段:历史消息;
- output_type 字段:输出类型,规定模型要返回什么样的对象。
Context 还可以加入记忆、AGENTS.md 等字段,但最小实现保留这四个就够。output_type 用泛型定义,因为 Context 会用于不同任务:回复用户时要求模型返回 AssistantMessage,审核工具调用时要求返回审核结论,输出类型随任务变化。
角色:Assistant 与 ToolCallReviewer
流程里有两次模型调用所需的上下文并不相同:一次是回复用户,一次是审核工具调用。领域层定义两个角色分别包装这两类上下文的产生过程:
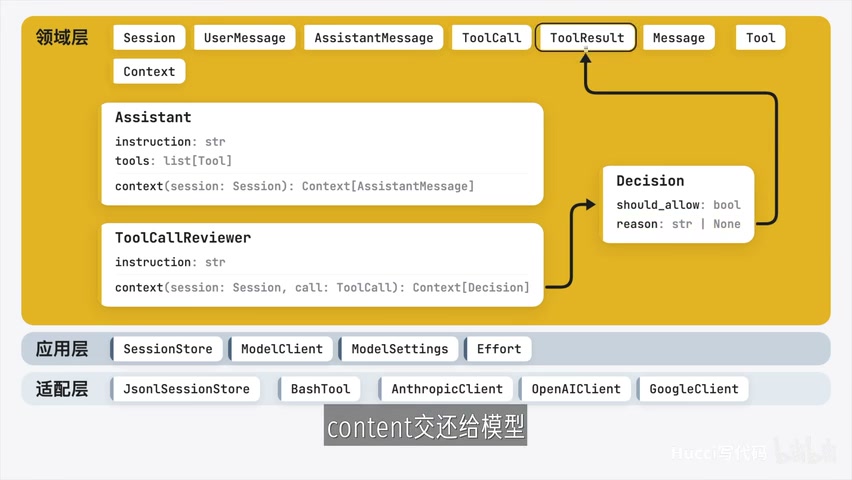
- Assistant:回复用户的角色,拥有自己的 instruction 和 tools,context 方法输入一个 Session,产出的 Context 中 output_type 是 AssistantMessage;
- ToolCallReviewer:审核工具调用的角色,有自己的 instruction 但不需要工具,context 方法输入一个 Session 和待审核的 ToolCall,产出的 Context 中 output_type 是 Decision。
Decision 是为审核结论新定义的类型,包含两样东西:这次调用能否执行,以及拒绝时的原因。被拒绝时,这个原因会作为 ToolResult 的 content 交还给模型。
应用层:接口与编排
领域概念定义完,应用层做两件事:为外部服务定义接口,把完整流程编排起来。
依赖倒置:接口在应用层,实现在适配层
为了存取对话,应用层定义一个 SessionStore 接口,规定存储需要哪些方法:列出对话、存对话、取对话。
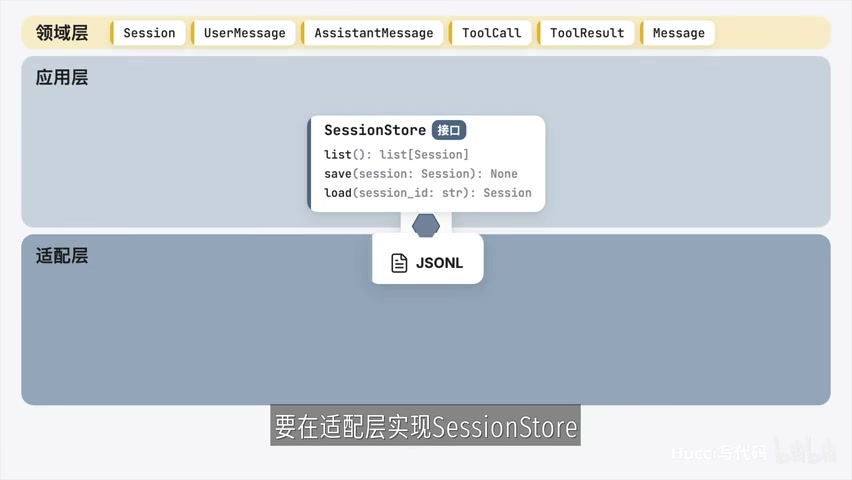
这里有一个关键的设计决策:SessionStore 是接口,放在应用层;真正的实现放在适配层。应用层只依赖接口而不依赖具体的类,带来两个好处:
- 更换技术实现时不需要改动应用层的任何代码;
- 测试时可以换一个假的存储实现,不需要真实的文件系统或数据库。
这就是依赖倒置:依赖的方向指向抽象,而不是指向具体实现。
编排:AgentService
应用层用一个 AgentService 类把整个流程编排起来:
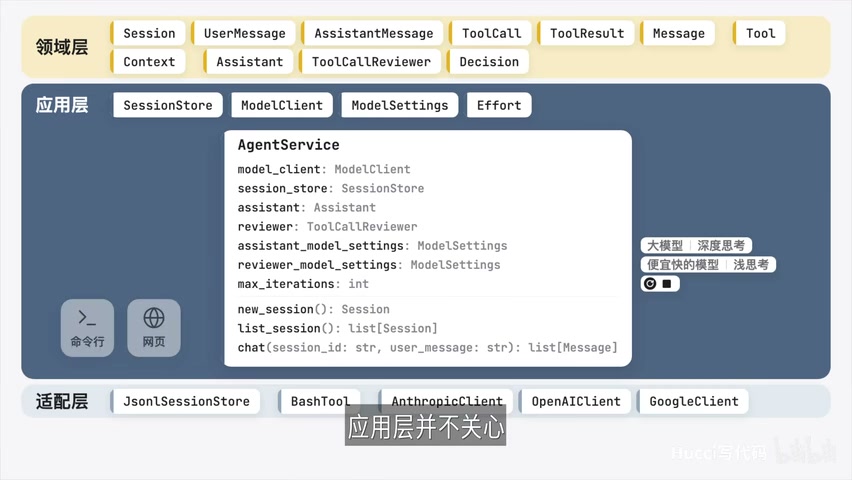
- 持有一个 ModelClient 和一个 SessionStore,用于访问外部服务;
- 持有 Assistant 和 ToolCallReviewer 两个角色,以及各自独立的模型设置——两个角色可以用不同的模型和思考深度,审核角色可以用更便宜更快的模型;
- 持有循环次数上限 max_steps,防止模型反复调用工具停不下来;
- 提供所有前端需要调用的功能:新建对话、列出对话、发送消息。
前端是命令行还是网页,应用层不关心,那是适配层的事情。
调用模型的能力同样在应用层定义接口:ModelClient 只有一个 generate 方法,输入 Context 和模型参数,返回 Context 中 output_type 指定的类型。模型参数指用哪个模型、思考多深,用一个 ModelSettings 对象包装,因为这两个参数总是成对出现。effort 定义了 6 档,与各模型厂商的实际档位有差别,翻译工作交给适配层。
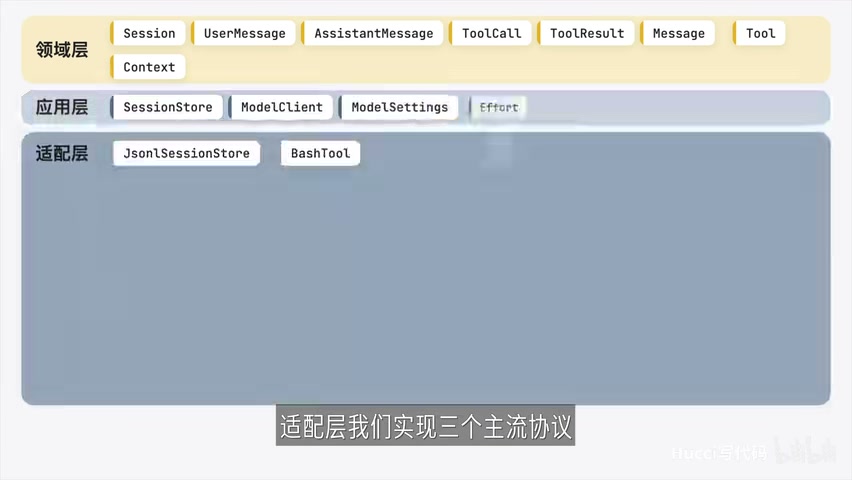
适配层:翻译外部世界
适配层实现应用层定义的所有接口,把外部的东西翻译成系统语言。
存储一侧,实现一个 JsonlSessionStore:每条对话存成 JSONL 文件里的一行,相比接口多出一个文件路径字段。
模型一侧,实现三个主流协议的客户端:
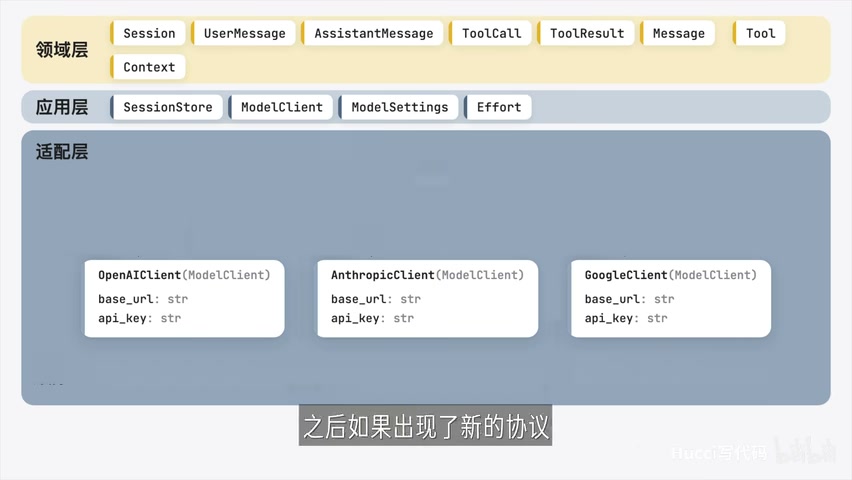
- OpenAI 客户端、Anthropic 客户端、Google 客户端,三家的请求格式各不相同;
- 单是思考深度这一个概念,各家叫法就不同:OpenAI 叫 reasoning effort,Anthropic 叫 thinking budget,Gemini 叫 thinking level,适配层负责把系统的 effort 翻译成各家的参数;
- 之后出现新的协议,在适配层新定义一个类即可,只要实现了 ModelClient 接口,应用层无需任何修改。
工具一侧,具体工具实现领域层的 Tool 接口,比如一个 BashTool 让模型能执行 bash 命令。前端一侧,如果前端是网页,适配层提供 HTTP 接口,把前端请求转成对 AgentService 的调用;以后新增 CLI 前端,再加一个适配器即可。
组装根:唯一知道具体类的地方
三层都写完,各层之间只通过抽象打交道:AgentService 只认识 ModelClient 接口和 SessionStore 接口,不知道世界上有 AnthropicClient 和 JsonlSessionStore。还差最后一步,把具体的类创建出来接到一起:
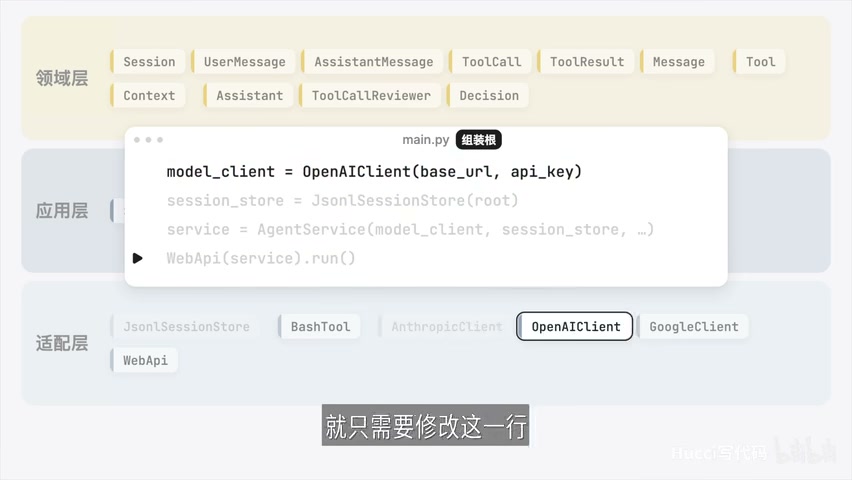
这个负责组装的地方叫组装根(Composition Root),也是启动服务的地方。它是整个系统里唯一知道所有具体类的地方:换模型、换存储、换入口、换任何具体实现,都只改这一个文件。比如想从 Claude 模型换成 GPT 模型,只需要修改一行代码。
最终的目录结构:
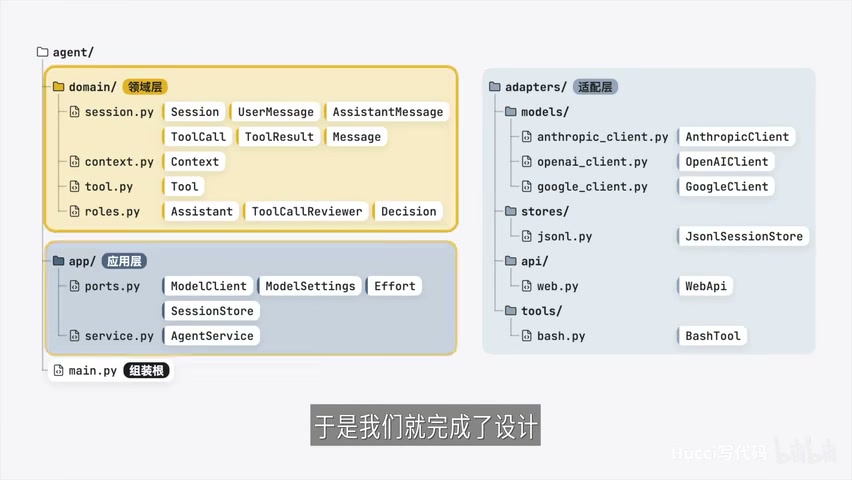
- 领域层:session、message、context、tool、role 等概念定义;
- 应用层:SessionStore、ModelClient 接口与 AgentService 编排;
- 适配层:三个模型客户端、JsonlSessionStore、BashTool、WebApi;
- 组装根:main.py。
把设计交给 AI,用 TDD 兜底
这套设计还有一个现实用途:把上面所有设计结论放进和 AI 的对话框里,让 AI 帮你实现。别忘了加上之前提过的 TDD 策略,让它先写测试再实现。
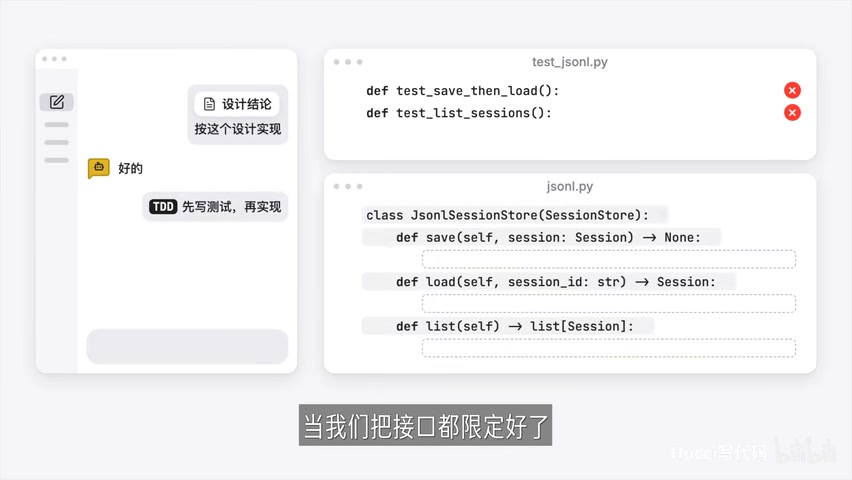
接口都限定好之后,AI 只需要实现功能,代码质量绝对不会差到哪里去。这也从侧面说明了这套设计的价值:架构清晰的系统,连 AI 都不容易写坏。
总结
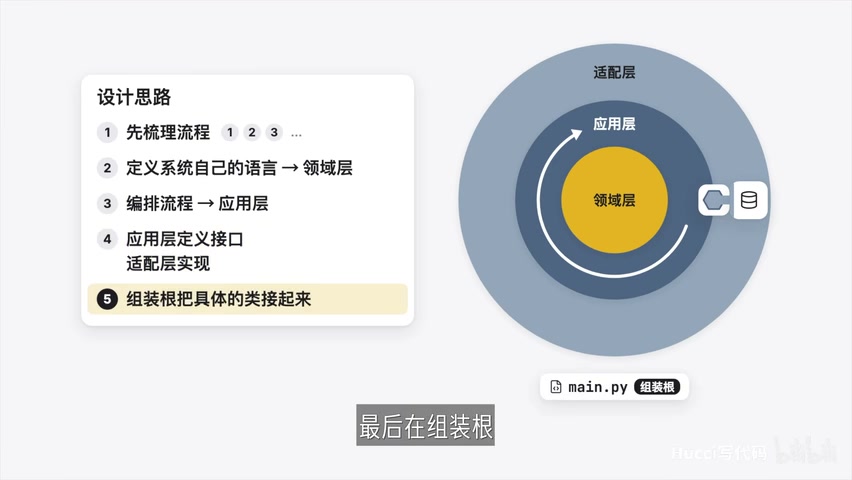
整套设计思路可以压缩成五句话:
- 先梳理流程,把系统要做的事情一步步列清楚;
- 建立一套系统自己的语言作为领域层;
- 在应用层编排流程,并为外部服务定义接口;
- 在适配层实现接口,翻译外部存储、外部模型和前端入口;
- 最后在组装根把具体的类接起来,依赖都指向领域层。
这套思路可以用在任何系统上,而不只是 Agent 系统。视频最后还留了两个练习:分叉对话,用户从已有对话的某条消息分支出一个新对话,带着之前的全部历史,之后各走各的互不影响;对话压缩,对话变长后让模型把较早的消息总结成摘要,之后发给模型的只是摘要加最近的消息。有兴趣可以自己设计一下这两个功能。
参考资料
- 视频原文地址: https://www.bilibili.com/video/BV1winH6DEgt
- 视频截图来源: B站视频「10分钟学会设计 Agent 架构」,UP主 Hucci写代码,本文配图截取自该视频画面