【LLM】Transformer 位置编码的演进:从可学习向量到旋转编码
2023 年前后,几乎所有大模型的结构图里都有一个不起眼的小模块,名字叫 RoPE(Rotary Position Embedding,旋转位置编码)。它出现在 LLaMA、Qwen、DeepSeek 等几乎所有主流开源模型里,却经常被一句”按位置旋转一下”带过。本文把位置编码这条演进线从头理一遍:每一代技术都从”上一代解决不了什么”讲起,先给动机,再给细节。
注意力机制看不见顺序
Transformer 的核心是自注意力(Self-Attention):每个 token(词元)拿自己的 query(查询向量)和所有 token 的 key(键向量)算相似度,再按相似度加权平均它们的 value(值向量)。整个过程只做”两两比相似度、加权求和”,没有任何一步用到 token 的下标。
这带来一个反直觉的性质:把输入序列打乱,注意力的输出只是跟着同样打乱,每个 token 拿到的信息一模一样。数学上叫置换不变性(permutation invariance)——改变输入排列,函数的输出集合不变。
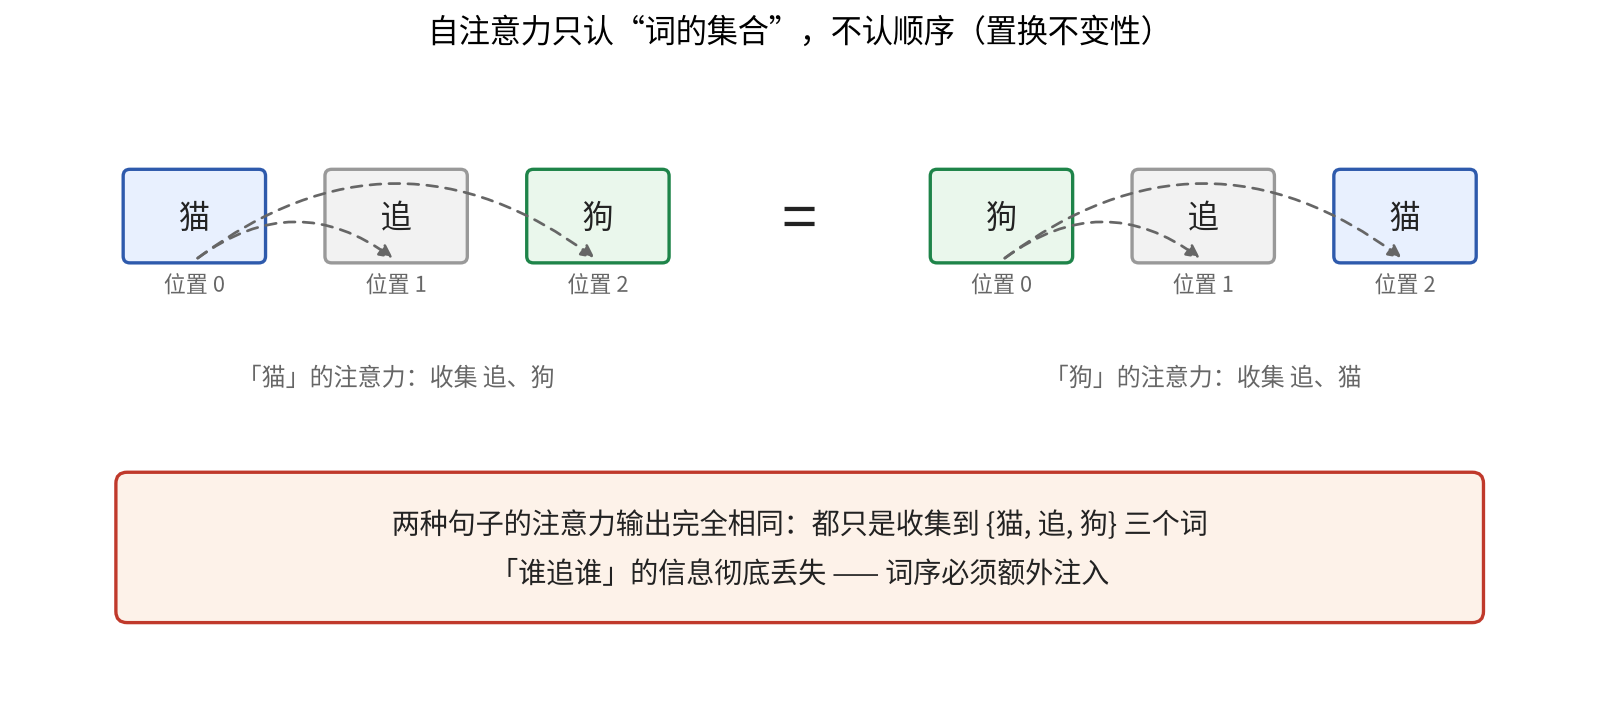
看一个具体例子。模型读到”猫追狗”:
- “猫”通过注意力收集到:句子里有一个”追”和一个”狗”。
- “狗”通过注意力收集到:句子里有一个”追”和一个”猫”。
换成”狗追猫”,结果完全相同:”狗”收集到”追”和”猫”,”猫”收集到”追”和”狗”。可这两句话的意思正好相反——谁追谁,取决于谁在前面。注意力本身对此完全失明,词序信息必须在输入端额外注入,这就是位置编码(Position Encoding)的全部使命。
第一代:绝对位置编码
原版 Transformer(Vaswani et al., 2017)的答案是给每个位置生成一个固定的向量,直接加到 token embedding(词向量)上。位置编码论文里给出的正弦位置编码(Sinusoidal Position Embedding)公式如下:
1 | PE(pos, 2i) = sin(pos / 10000^(2i/d)) |
这个公式出现在这里,是想说明位置编码是一个解析函数而不是学习参数:d 是向量维度,pos 是位置下标,不同 i 对应不同频率的正弦波。可以把每一维想象成一根指针——有的转得快,有的转得慢,每个位置 pos 在 512 根指针上留下唯一一组角度组合,像一枚不会重复的指纹。不需要训练,长度理论上还能任意延伸。
2018 年的 BERT(Devlin et al., 2019)换了个更简单粗暴的方案:直接开一张查找表(look-up table),每一行是一个可训练向量,训练时让模型自己学”每个位置该长什么样”。BERT 设置了 max_position_embeddings = 512,即表里只有 512 行。
这一代方案注入的都是绝对位置:模型拿到的信号是”你在第 3 格”,而不是”你离某个词 3 格远”。它们简单有效,撑起了 BERT 和 GPT-2 时代。但有三个硬伤,每一个都在后来的真实场景里爆过雷。
第一代的三个硬伤
第一个硬伤是相对位置不可辨。位置 3 的词看到位置 6 的词,与位置 10 的词看到位置 13 的词,间隔都是 3,语义模式完全同构(比如都是”主语 + 三格 + 谓语”),但模型眼里它们毫无关系:第一组拿到的是”我带 3 号向量、对方带 6 号向量”,第二组是”我带 10 号、对方带 13 号”,两组四个向量互不相干。语言里满是这类模式:「猫把鱼吃了」和「实验把误差放大了」,”把”字都紧挨在动词前 1 格,句式完全相同,可它们在语料中出现的位置千变万化,绝对位置编码只能把”把在 2 号位”和”把在 20 号位”当成两件不相干的事分别去学。模型无法把”隔 3 格”抽象成一个可复用的概念,样本效率天然低。
第二个硬伤是长度外推。查找表的行数在训练时就定死了,BERT 的表只有 512 行,推理时来了一个 1024 token 的文档,第 513 行根本不存在。训练 512、推理 512 以上的场景直接失效,这在长文档检索、长对话出现之前,是很多团队真正撞上过的墙。
第三个硬伤是加法耦合。token embedding 和位置向量是直接相加的,混合之后”哪些成分承载语义、哪些承载位置”搅在一起,缺乏解释性。这一条不像前两条那样致命,但它埋下了疑问:加法真的是注入位置的最好方式吗?
中间站:把相对位置写进注意力
沿着”第一代学不到相对位置”这个缺口,2019 到 2022 年间出现了一批改进,它们不再往输入端加向量,而是直接改注意力内部。
Transformer-XL(Dai et al., 2019)把 query 和 key 的相对距离显式引入注意力打分:打分时除了内容相似度,还加上一项”我们隔多远”的偏置。T5(Raffel et al., 2020)走得更简:预先定义一组相对距离的桶(距离 1、2-3、4-7……越远桶越宽),每个桶学一个标量偏置,加到注意力分数上。这类方法的取舍是:相对信号确实进来了,但它们修改了注意力计算本身,每个注意力头要额外维护一套偏置参数,实现散落在 attention 内部,和 FlashAttention 这类高效算子配合时也比较别扭。
ALiBi(Attention with Linear Biases,线性偏置注意力,Press et al., 2022)把这条路线推到极简:不引入任何参数,直接给注意力分数加一个惩罚项——距离每远一格,分数按固定斜率线性扣减。效果像”离得越远,话越轻”:模型天然更关注邻近 token。拿具体数字感受一下,斜率取 0.5 时,紧邻的 token 扣 0.5 分,隔 10 个 token 扣 5 分,隔 40 个扣 20 分——在动辄十几分的原始打分面前,远处 token 的话语权被持续压低。它的意外收获是外推能力很强,训练 1024 长度、推理跑数千长度不崩:惩罚规则是解析的,距离多远都能照算,不存在”查表查不到行”的问题。代价是表达力:它只编码”远近”这一个标量,左右方向完全对称,也塞不进更丰富的位置结构。
这些方法各自在某个维度上前进,但都动了注意力的内部结构。真正优雅的答案要等到换一个几何视角。
第二代:RoPE
RoPE(Su et al., 2021,RoFormer 论文)的出发点可以概括成一句话:能不能用绝对位置的方式,实现相对位置的效果。也就是说,注入时每个 token 只需要自己的位置号(实现简单、不用改注意力结构),但两个 token 配对时,起作用的只有它们的距离差。
把这条动机链摆得更直白一点。第一代分不清相对位置,是因为内积里同时混进了 m 和 n 两个绝对下标,配对后没有任何东西可以抵消;第一代不能外推,是因为位置向量查表而来,表只编到训练时的最大长度。想同时解除两个硬伤,就要找一种操作:配对时绝对下标自动抵消成差值,同时对任意大的位置号都能解析地算出角度。旋转恰好两条都占——这是它从一众候选里胜出的根本原因。
设计出人意料地简单:把每个 token 的向量在二维平面上按自己的位置旋转一个角度。先用最简单的二维情形看清楚原理。把向量 q 按角度 θm 旋转,就是把它的坐标做一次平面旋转:
1 | q' = (q.x * cos(θm) - q.y * sin(θm), |
这个旋转公式放在这里,是为了看清下面这步几何账。两个向量的内积等于”长度 × 长度 × 夹角余弦”,而旋转有一个关键性质:只改变方向,不改变长度。于是 query 转了 θm、key 转了 θn 之后,两者之间的夹角只多转了 θm − θn,内积就变成:
1 | q' · k' = |q| |k| cos(原始夹角 + θm − θn) |
m 和 n 各自的绝对位置在式子里消失了,只剩下差 θm − θn。取 θm = m·θ、θn = n·θ(角度随位置线性增长),内积就只依赖 m − n,正是相对位置。
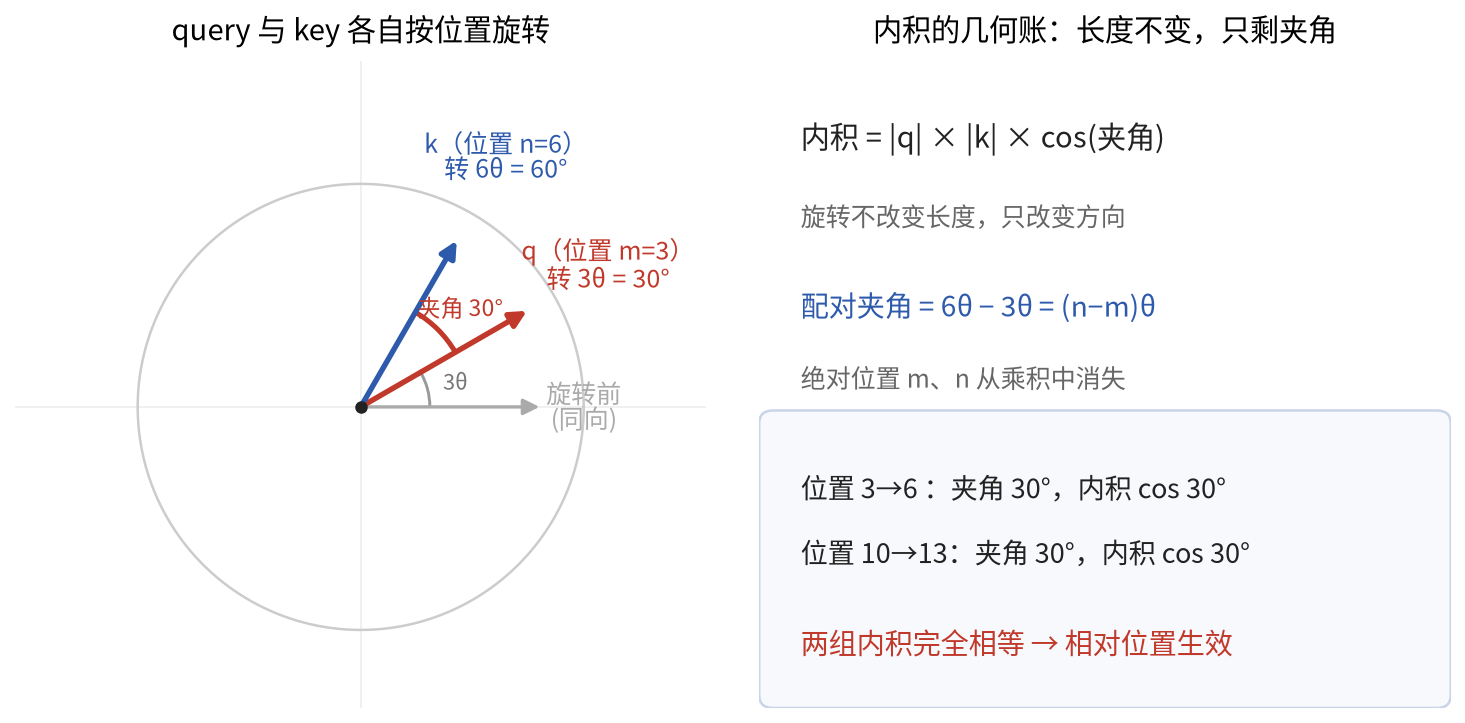
用具体数字过一遍:设 q 和 k 同向(原始夹角 0)。位置 3 的 q 转 30°,位置 6 的 k 转 60°,配对夹角 30°,内积是 cos 30°;换成位置 10 的 q 和位置 13 的 k,一个转 100°、一个转 130°,夹角还是 30°,内积还是 cos 30°。第一代无法分辨的”3→6 与 10→13”,在旋转视角下自动等价。每个 token 单独旋转是绝对操作,配对之后只剩下差值——这就是”绝对变相对”的全部魔术。熟悉复数的话还有个更短的看法:旋转就是乘一个模长为 1 的复数,内积自然只留下指数上的位置差。
还有一个实现层面的问题:为什么旋转总是按”对”操作?旋转是二维平面上的概念,方向转了一个角度——单个数字没有”方向”,谈不上旋转;必须把两个数组成一个平面,才有了方向、才转得起来。这也正是复数乘法的视角:把 (q.x, q.y) 看成复数 q.x + q.y·i,旋转角度 θ 就等于乘上一个模长为 1 的复数 cos θ + sin θ·i,一次乘法同时搅动实部和虚部。于是一个 d 维向量被两两配对成 d/2 个独立的小平面,每个平面转自己的角度、互不干扰——旋转的”最小施工单元”是二维,注定了配对结构。
为什么需要多组不同频率
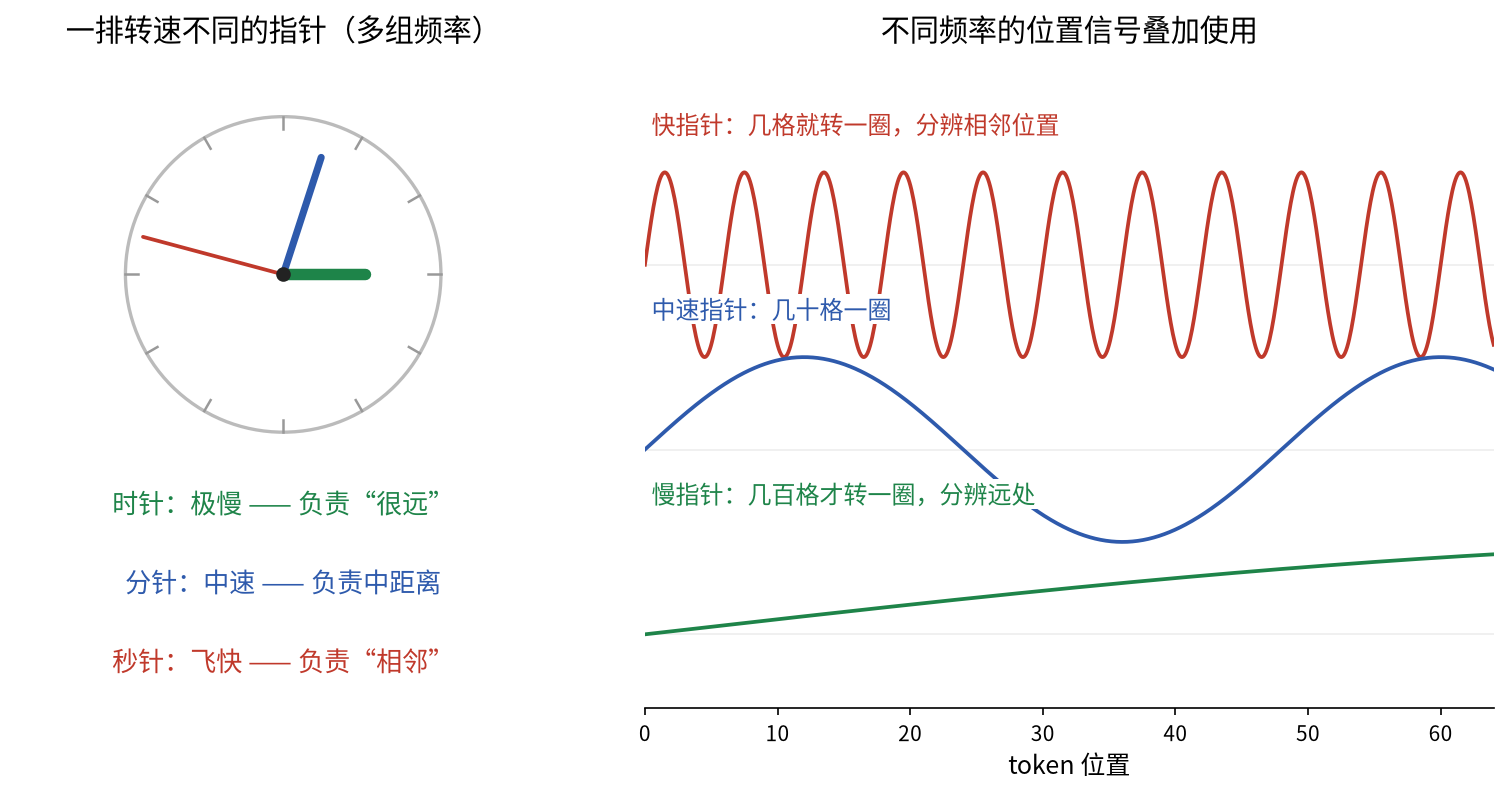
上面的设计只用了”一根指针”:一个频率 θ。这有明显破绽——指针转一圈回到原点,位置 0 和位置”一整圈之后”(比如第 2π/θ 格)拿到的角度完全相同,内积无法区分,周期性混淆就发生了。
解决办法是同时使用很多根转速不同的指针,像一排钟表:秒针转得飞快,负责分辨近处的先后;分针时针转得极慢,负责分辨远处。用具体数字体会一下这种分工:只用秒针时,它每 60 格转回原点,位置 5 和位置 65 的角度完全一样,模型分不清”主语在 5 号位”和”主语在 65 号位”;而配上时针(比如 720 格才转一圈)之后,这两处的秒针角度相同、时针角度差了 30°,混淆自动解除。一组向量里安排几十上百种频率,近处靠高频指针区分,远处靠低频指针区分,想让所有指针同时转回原点,需要的距离是所有周期的公倍数——只要最慢的指针周期足够长(比如几万个位置),在真实上下文长度内就不会混淆。
RoPE 论文用逆频率向量(inverse frequency,inv_freq)一次性给出全部频率:
1 | θ_i = 10000^(-2i/d),i = 0, 1, ..., d/2 - 1 |
这行公式在这里,是为了说明频率的分布规律:i = 0 时频率是 1(最快),i 增大时按几何级数递减(最慢的约几万格才转一圈),对数均匀地铺满从快到慢。d 维向量两两配对成 d/2 根指针,每根用自己的频率旋转。可以把 inv_freq 理解成”坐标换算成旋转角”的转速表:位置号 m 本身只是一个格数,乘上每根指针的频率,才得到它该转的角度 θm = m·θ_i——inv_freq 定的就是每根指针”每走一格转多少弧度”。它由 base 和 dim 两个超参用纯公式生成,没有任何参数可学。
落到 PyTorch 实现里,就是 transformers 库中 RotaryEmbedding 的骨架:
1 | class RotaryEmbedding(nn.Module): |
这段代码值得注意的地方是它没有任何 nn.Parameter:inv_freq 由 dim 和 base 两个超参完全确定,用 register_buffer 注册——它会随模型权重一起保存和加载,但优化器不会更新它。第一代”位置向量要训练”的设定,在这里被整个掀掉了。训练时模型要做的只是学会”在旋转后的坐标系里表达语义”,位置本身零参数。
用 Qwen3.5 的真实配置把上面的数字全部落一次地:它的注意力头维度是 256,但只有 64 维参与旋转(配置里 partial_rotary_factor = 0.25,剩下的维度不注入位置信息,留给模型自由使用),64 维两两配对正好是 32 根指针。base 取 10,000,000,代入 inv_freq 公式:最快的指针每格转 1 弧度,约 6 个 token 就转满一圈,专门分辨紧邻的先后;最慢的指针要约三千八百万个 token 才转完一圈,在 26 万 token 的原生上下文里总共只转过约 2.5°——想让它俩在所有指针上同时混淆,需要等所有周期的公倍数,现实中不会发生。前一代常见的 Llama 类配置(base 10,000、128 维全旋转)最慢指针周期约五万 token,Qwen3.5 把它推高了三个数量级,这正是长上下文时代把 base 一路调大的原因。
多模态扩展:M-RoPE
文本是一维序列,位置用一个整数就够。但图像是二维网格,视频还要加上时间轴。Qwen2-VL(Wang et al., 2024)把 RoPE 推广成多模态旋转位置编码(M-RoPE,Multimodal Rotary Position Embedding):每个 token 的位置从一维编号升级成三维坐标(时间 t,行 h,列 w),并把向量的维度切成三段频段,三段分别按 t、h、w 的角度旋转。
三种模态在这个框架下自然统一:
- 文本 token:t、h、w 三个值始终相等,一起随序列推进,退化成普通的一维 RoPE,纯文本行为和原版完全一致。拿真实数字看,句子里第 10 个 token 的坐标就是 (10, 10, 10),第 11 个是 (11, 11, 11)——三个轴同步递增,和一维 RoPE 给位置 10 记一个”10”没有任何区别。
- 图像 token:t 恒定(同一张图属于同一时刻),h 和 w 是 patch(图块)在网格中的行列号,空间结构直接进入角度。一张图第 2 行第 5 列的 patch,坐标是 (t₀, 2, 5),t₀ 是这张图在整段输入里的起始时间位。
- 视频 token:t 是帧号,h、w 是每帧内的网格坐标,时间和空间各有各的指针。第 3 帧第 0 行第 0 列的格子是 (3, 0, 0),第 7 帧的同一格子是 (7, 0, 0)。
一个直观的类比:处理一段视频时,模型手里有一叠按时间排列的照片,每张照片里的每个格子还有自己的行列号;t、h、w 三组指针分别转着,”第 3 帧左上角”和”第 3 帧右上角”共享时间角度、只差空间角度,而”第 3 帧”和”第 7 帧”的同一格子只差时间角度。相邻帧内容变化慢、画面内相邻格子内容也相近,这些先验都被角度差直接表达了出来。
2025 年的 Qwen3-VL 技术报告(arXiv:2511.21631)又把频段分配从”按段切分”升级为交错式(Interleaved-MRoPE):t、h、w 三组频率不再各占一块维度,而是交错铺满整个维度范围,让三个轴都均匀覆盖从快到慢的频谱,改善了原切法里时间轴偏向高频、空间轴偏向低频的偏置。设计在细化,骨架未变。
频段怎么切,配置文件里写得明明白白。Qwen2-VL 的 64 对频率按 mrope_section = [16, 24, 24] 切成三块:前 16 根指针全按 t 转,中间 24 根按 h,最后 24 根按 w。到了 2026 年 2 月发布的 Qwen3.5,交错分配直接成了出厂设置:mrope_interleaved = true,32 对频率按 mrope_section = [11, 11, 10] 交错分配——t、h、w 轮流挑指针,三根秒针、三根分针、三根时针各拿各的,谁也不会被整体锁死在某一段频谱上。一个只在纯文本里跑的请求,三组坐标虽然同步递增,指针的分配依然保持交错,机制上没有任何特判。
两代同框
把两代技术放在一张表里对齐,能看清演进的真实方向:
| 维度 | 第一代(Sinusoidal / BERT) | 第二代(RoPE) |
|---|---|---|
| 注入方式 | 加到 token embedding 上 | 旋转 query 和 key 向量 |
| 位置语义 | 只有绝对位置 | 注入绝对、配对后只留相对 |
| 位置来源 | 查找表 | 解析函数(公式直接生成) |
| 是否可训练 | Sinusoidal 不可训练,BERT 表可训练 | 零参数,register_buffer 固定 |
| 长度外推 | 表行数定死,基本不能外推 | 天然支持任意位置,长上下文常配合微调 |
今天典型的视觉语言模型(VLM,Vision-Language Model)里,两代技术常常同框。以 LLaVA 这类基于 CLIP 视觉塔的主流 VLM 为例:视觉编码器是一个经典 ViT(Vision Transformer,视觉 Transformer),内部用的正是第一代——一张可学习的绝对位置嵌入查找表,一张 224×224 的图像切成 14×14 个 patch,加上一个 CLS token,表就是 197 行;而 LLM 主干一侧清一色是 RoPE。更有意思的是,第一代的老毛病在视觉侧原样重演:换更高分辨率的图像,patch 数变多,表不够长,只能把 224 尺寸训出来的位置表插值到新尺寸——这正是当年 BERT 超过 512 token 的窘境换个马甲。
不过演进并未停在这一步:Qwen-VL 系列自己的视觉塔没有沿用可学习表,而是已经换成了 2D-RoPE(行列各一套角度),等于把 LLM 侧验证过的方案反向移植回了视觉编码器。位置编码这条线,从 2017 年的 512 根正弦指纹走到今天的三维旋转指针,核心驱动力始终没变——下一个位置结构出现了,就为它造一种编码。
演进时间线
1 | 2017 Sinusoidal PE 原版 Transformer,解析函数生成绝对位置,与词向量相加 |
参考资料
- Vaswani et al., 2017, Attention Is All You Need: https://arxiv.org/abs/1706.03762
- Devlin et al., 2019, BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding: https://arxiv.org/abs/1810.04805
- Dai et al., 2019, Transformer-XL: Attentive Language Models Beyond a Fixed-Length Context: https://arxiv.org/abs/1901.02860
- Raffel et al., 2020, Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5): https://arxiv.org/abs/1910.10683
- Su et al., 2021, RoFormer: Enhanced Transformer with Rotary Position Embedding: https://arxiv.org/abs/2104.09864
- 苏剑林, 2021, Transformer升级之路:2、博采众长的旋转式位置编码: https://kexue.fm/archives/8265
- Press et al., 2022, Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation (ALiBi): https://arxiv.org/abs/2108.12409
- Wang et al., 2024, Qwen2-VL: Enhancing Vision-Language Model’s Perception of the World at Any Resolution: https://arxiv.org/abs/2409.12191
- Qwen Team, 2025, Qwen3 Technical Report: https://arxiv.org/abs/2505.09388
- Qwen Team, 2025, Qwen3-VL Technical Report: https://arxiv.org/abs/2511.21631
- Qwen Team, 2026, Qwen3.5 模型卡(head_dim 256、partial_rotary_factor 0.25、mrope_section [11,11,10]): https://huggingface.co/Qwen/Qwen3.5-35B-A3B-FP8